
Локальный ИИ‑агент on‑premise: когда нужен закрытый контур


Короткий ответ: когда закрытый контур действительно нужен
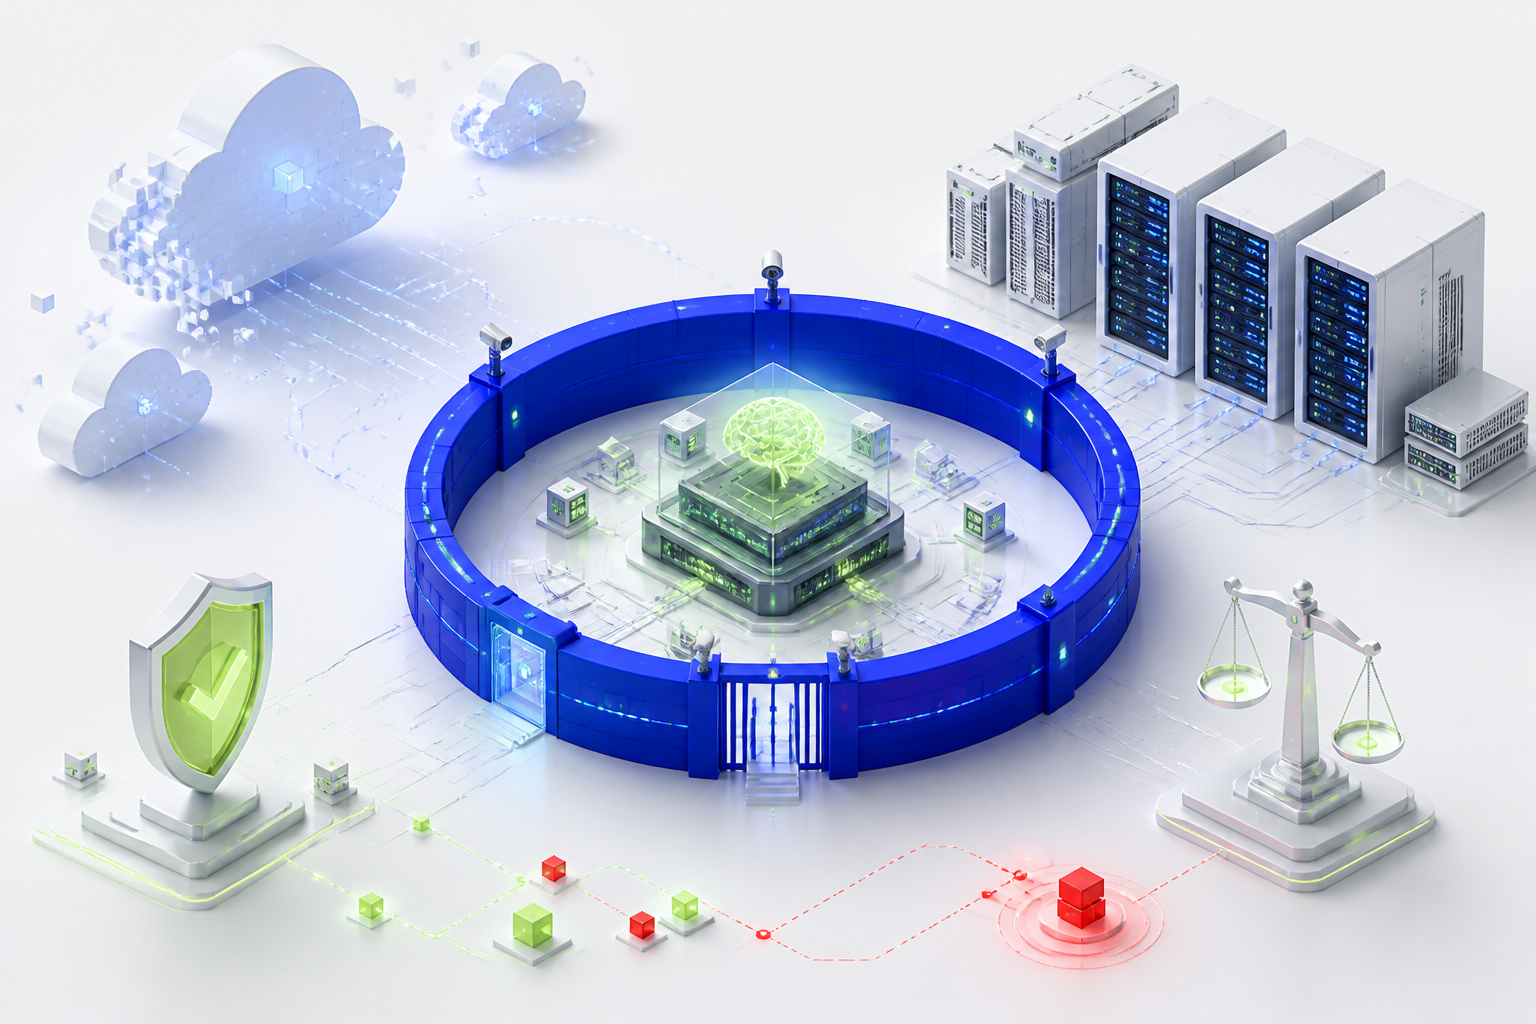
Локальный ИИ-агент on-premise нужен не всем. Более того, в большинстве проектов собственный закрытый контур оказывается дороже, сложнее и иногда слабее по качеству, чем аккуратно настроенная облачная архитектура. Но есть три ситуации, где спор почти заканчивается: регулятор запрещает вынос данных, возможная утечка стоит дороже всего проекта или нагрузка настолько высокая и ровная, что своё железо начинает выигрывать экономически.
Главная ошибка в таких решениях — начинать с ощущения: «нам безопаснее у себя». Правильнее начинать с данных: какие документы обрабатывает агент, есть ли персональные данные, медицинская тайна, конструкторская документация, государственная тайна, требования аттестации, ограничения по КИИ, внутренние политики банка или промышленного холдинга. Закрытый контур — это больше контроля над данными ценой бюджета, инфраструктуры, людей а иногда и качества модели.
В 2026 году к этой картине добавился новый аргумент. Компании стали осторожнее относиться к договорным гарантиям облачных провайдеров, потому что условия хранения и обработки данных могут меняться. Договорное обещание «мы не храним ваши запросы» и техническая невозможность вывода данных за периметр — разные уровни защиты. Если модель угроз не допускает изменения правил поставщиком, локальная LLM для бизнеса становится не прихотью, а частью архитектуры риска.
Что такое локальный ИИ-агент on-premise
Локальный ИИ-агент on-premise — это не просто «нейросеть на своём сервере». Обычно речь идёт о связке из языковой модели, базы знаний, слоя прав доступа, коннекторов к внутренним системам, журналирования, интерфейса для сотрудников и средств мониторинга. Агент может отвечать по регламентам, искать информацию в договорах, помогать инженеру с документацией, формировать черновики писем, извлекать поля из актов и накладных, работать с 1С или внутренним документооборотом.
Ключевое отличие on-premise-размещения в том, что данные не покидают инфраструктуру заказчика или специально выделенный для него контур. Это может быть серверная внутри организации, частное облако в российском дата-центре, изолированный сегмент у интегратора или гибридная схема, где чувствительные запросы идут локально, а общие — в облачную модель.
Важно не путать несколько понятий. LLM — большая языковая модель, которая генерирует текст и анализирует документы. RAG — Retrieval-Augmented Generation, подход, при котором модель сначала ищет релевантные фрагменты в базе знаний, а затем отвечает на их основе. Закрытый контур — архитектура, в которой данные и вычисления остаются внутри заданного периметра. Именно сочетание этих элементов превращает модель в полезного корпоративного агента, а не в демонстрационный чат.
Три причины, по которым действительно нужен свой контур
Первая причина — прямое требование регулятора или отраслевых правил. Это не ситуация «мы бы предпочли не отправлять документы наружу», а ситуация «нам нельзя». В эту зону попадают отдельные государственные информационные системы, значимые объекты критической информационной инфраструктуры, часть медицинских, финансовых и промышленных контуров, а также системы, где предусмотрена аттестация и формальная модель угроз.
Вторая причина — данные, утечка которых дороже проекта. Врачебная тайна, массивы персональных данных, конструкторская документация, договорная база, сведения о поставщиках и ценах, внутренние расследования, материалы службы безопасности — всё это может быть слишком чувствительным для отправки внешнему API даже при хороших договорных условиях. Здесь вопрос не только в штрафах. Репутационный ущерб, остановка закупок, судебные споры или потеря технологического преимущества иногда стоят намного больше лицензий и серверов.
Третья причина — высокая и ровная нагрузка. Если ИИ-агент обрабатывает большие объёмы запросов каждый день, без резких провалов ночью и на выходных, собственная инфраструктура может стать дешевле облака. Но порог безубыточности выше, чем часто пишут в презентациях поставщиков железа. Его нельзя считать только по цене видеокарты и стоимости токена в API: нужно учитывать утилизацию, резервирование, администрирование, обновления и людей.
Есть и обратная сторона. Закрытый контур обычно не нужен, если аргумент звучит как «у нас коммерческая тайна», но без понимания, какие именно данные уходят в модель и чем это запрещено. Он часто не нужен, если задача сводится к общим вопросам, маркетинговым текстам, внутренним черновикам без персональных данных или справке по открытым материалам. Фраза «не хотим, чтобы данные ушли за границу» тоже не всегда означает on-premise: иногда достаточно российской модели в российском облаке, корректного договора и настройки хранения.
Что изменилось в 2026 году: облака стали менее предсказуемыми
До недавнего времени многие компании строили компромисс вокруг режима нулевого хранения данных. Логика была понятной: запрос уходит в облачную модель, но провайдер договорно обязуется не хранить его и не использовать для обучения. Для части задач этого было достаточно, особенно если данные предварительно обезличивались.
В 2026 году этот подход стал восприниматься осторожнее. По отраслевым обсуждениям, Anthropic с 9 июня 2026 года ввела обязательное 30-дневное хранение данных для Covered Models, переопределив ранее заключённые соглашения о нулевом хранении. Перед публикацией и перед принятием управленческих решений такую формулировку обязательно сверяют с официальным уведомлением поставщика и действующим договором, но сам сигнал важен: условия облачного сервиса могут измениться быстрее, чем корпоративная архитектура.
У OpenAI режим нулевого хранения также не является простой галочкой для всех. Он требует отдельного одобрения и может покрывать не все точки API. Для бизнеса это означает, что архитектура комплаенса не должна строиться на предположении «у всех больших провайдеров данные точно не хранятся». Нужно смотреть конкретный продукт, конкретную точку доступа, договор, регион, режим логирования и исключения.
Договорные гарантии — это не то же самое, что техническая невозможность. Если риск-модель допускает одностороннее изменение условий поставщиком, единственный надёжный способ исключить передачу данных — сделать так, чтобы они физически не покидали контур.
Это не аргумент против облаков вообще. Облачные модели часто лучше, быстрее внедряются и дешевле на старте. Но для госсектора, здравоохранения, финансов, промышленности и компаний с жёсткими требованиями к данным появился более сильный повод считать не только цену токена, но и устойчивость договорной модели.
Что говорит российское законодательство
Российское регулирование задаёт ограничения, из-за которых локальный ИИ-агент или LLM в закрытом контуре становится естественным вариантом для части организаций. В первую очередь это касается персональных данных, государственных систем, критической информационной инфраструктуры и закупок, где требуется российское ПО.
ФЗ-152, часть 5 статьи 18 в редакции, действующей с 01.07.2025, требует обеспечить запись, систематизацию, накопление, хранение, уточнение и извлечение персональных данных граждан РФ с использованием баз данных, находящихся на территории России. На практике это не всегда означает запрет на любые внешние сервисы, но требует внимательно разбирать, где именно хранятся данные, логи, векторные индексы, файлы, резервные копии и служебные журналы.
КоАП 13.11 с оборотными штрафами за утечки персональных данных меняет экономику разговора. При повторном нарушении штраф может составлять от 1% до 3% выручки, но не менее 20 млн и не более 500 млн рублей. Эти цифры не нужно использовать как страшилку. Их достаточно поставить рядом со сметой проекта, чтобы стало ясно: иногда бюджет закрытого контура выглядит разумно не потому, что железо дешёвое, а потому что риск дорогой.
Приказ ФСТЭК России № 117, действующий с 01.03.2026 и заменивший приказ № 17, требует отдельной юридической и технической проверки по конкретной системе. В отрасли его обсуждают как документ, расширяющий охват требований для информационных систем государственных органов, ГУП и учреждений, с обязательной аттестацией и ограничениями на использование публичных облачных сервисов для критичной информации. Точные формулировки всегда сверяются по тексту приказа и с профильным подрядчиком по защите информации.
Для объектов КИИ применимы ФЗ-187 «О безопасности критической информационной инфраструктуры» и связанные постановления, включая постановление Правительства № 1762. Для части государственных закупок имеет значение реестр российского ПО. Практический вывод простой: в госсекторе и на объектах КИИ вопрос часто звучит не «облако или свой контур», а «какое локальное решение проходит по нашим требованиям и как оно будет аттестовано».
Какие модели можно поставить у себя
За последние годы рынок моделей с открытыми весами стал достаточно зрелым. Для большинства корпоративных задач — поиск по регламентам, ответы по базе знаний, классификация обращений, извлечение реквизитов, подготовка черновиков — открытые модели уже достаточно хороши. Разрыв с закрытыми лидерами заметнее на сложных рассуждениях, агентном программировании и задачах, где важны многошаговая логика и редкие знания.
| Модель | Лицензия | Комментарий |
|---|---|---|
| gpt-oss-120b | Apache 2.0 | Заявляется как модель, помещающаяся на одну карту 80 ГБ; параметры и лицензию нужно проверять на дату внедрения. |
| gpt-oss-20b | Apache 2.0 | Около 16 ГБ в практических конфигурациях, подходит для рабочей станции и пилотов. |
| Qwen3.8, включая 27B | Apache 2.0 | Сильная линейка для русского языка и корпоративных сценариев. |
| DeepSeek-V4 | MIT | Крупная и требовательная модель; важны требования к железу и лицензии. |
| Mistral Large 3 | Apache 2.0 | Интересна для многоязычных сценариев и задач с длинным контекстом. |
| Gemma 4 | Apache 2.0 | По пользовательским данным, впервые в линейке заявлена свободная лицензия; проверяется перед внедрением. |
| Muse Glimmer 30B | Apache 2.0 | Модель среднего размера для локальных сценариев. |
| GigaChat 3.5 / 3.1 Ultra | MIT | Российская модель с документированным развёртыванием на своих серверах. |
| T-Pro 2.0 | Apache 2.0 | Российская модель, интересная для импортонезависимых контуров. |
Отдельная ловушка — лицензии и лимиты. Модель может быть открытой в техническом смысле, но иметь ограничения на коммерческое использование, объём генерации или типы пользователей. Например, для YandexGPT 5 Lite в открытом доступе обсуждается ограничение порядка 10 млн выходных токенов в месяц. Для пилота этого достаточно, для эксплуатации в крупной компании — нет. Поэтому выбор модели начинается не с рейтинга в бенчмарке, а с лицензии, лимитов, требований к данным и понятного сценария нагрузки.
Сколько нужно железа
Базовая арифметика видеопамяти выглядит просто. В 16-битной точности модели требуется примерно 2 ГБ VRAM на 1 млрд параметров. В 4-битном квантовании — около 0,5 ГБ на 1 млрд параметров. Значит, модель на 30 млрд параметров требует около 60 ГБ видеопамяти в FP16 или примерно 15–20 ГБ в 4-битном режиме с учётом накладных расходов.
Но эта арифметика отвечает только на вопрос «поместится ли модель». Она не отвечает на вопрос «сколько пользователей она обслужит». Главный фактор конкурентности — не только веса модели, но и KV-кэш, то есть кэш ключей и значений, который растёт с длиной контекста и числом одновременных запросов. Сервер, на котором модель формально запустилась, может уверенно обслуживать двух пользователей вместо двадцати, если сотрудники загружают длинные документы и ждут развёрнутых ответов.
В 2026 году расчёты осложнились ценами на ускорители. По пользовательским данным, RTX PRO 6000 Blackwell выросла примерно с $8 565 до около $16 000 за 17 месяцев, а RTX 5090 в рознице доходила до $5 000 при рекомендованной цене $1 999. Производители также предупреждают о дефиците памяти на горизонте до 2030 года. Для российского рынка это особенно важно: параллельный ввоз серверных ускорителей сжался, сроки поставки стали менее предсказуемыми, а сметы разумно считать с коэффициентом 2–3 к мировым ценам.
Для обслуживания моделей используют vLLM, SGLang, TensorRT-LLM и другие движки инференса. Единственного «самого быстрого» варианта нет: победитель меняется в зависимости от модели, длины контекста, числа одновременных запросов и профиля генерации. Поэтому зрелый проект начинается с замера на рабочей точке: типовые документы, реальные промпты, ожидаемое число сотрудников, целевое время ответа.
Сколько это стоит на самом деле
Публичные оценки точки безубыточности on-premise-инфраструктуры расходятся на три порядка: от 20 млн до 2 млрд токенов в месяц. Причина не в том, что кто-то обязательно ошибается в арифметике. Чаще разные авторы выбирают разные допущения: цену железа, срок амортизации, утилизацию, стоимость электричества, нагрузку в пике, качество модели, резервирование и зарплаты специалистов. Нередко такие расчёты публикуют компании, которые продают инфраструктуру, а значит допущения стоит читать особенно внимательно.
Ключевая переменная — утилизация. Сервер стоит одинаково и в пике, и ночью. Если он загружен на 20%, эффективная цена токена оказывается примерно в пять раз выше расчётной. Поэтому компания с нагрузкой «с 10 до 18 по будням» будет окупать своё железо намного дольше, чем компания, у которой обработка документов идёт круглосуточно и предсказуемо.
В совокупную стоимость владения входят не только GPU. Нужны серверы, сеть, стойки, размещение, электропитание, охлаждение, резервирование, мониторинг, обновления, резервное копирование, контур безопасности и люди. Самая дорогая часть часто не железо, а специалисты, которые умеют поддерживать модели, разбираться с деградацией качества, обновлять зависимости, закрывать уязвимости и объяснять бизнесу ограничения. Если средняя зарплата ML-инженера в РФ около 185 тыс. рублей на руки, полная стоимость сотрудника для компании с налогами и накладными расходами заметно выше.
Честный расчёт выглядит не как «облако против своего сервера», а как сравнение трёх вариантов на горизонте трёх лет: публичное облако, российское облако с моделью и хранением в РФ, собственный закрытый контур. Для каждого варианта считают не только цену токена, но и требования к данным, риски изменения условий, SLA, сроки запуска, качество ответов и стоимость сопровождения.
Безопасность локальной установки: её тоже надо настраивать
Самая опасная иллюзия on-premise-проектов звучит так: «мы поставили у себя, значит безопасно». На практике локальная установка требует настройки безопасности не меньше облачной. Иногда даже больше, потому что облачный провайдер берёт на себя часть инфраструктурной гигиены, а в собственном контуре ответственность полностью переходит к заказчику и интегратору.
Показательный пример — уязвимости и неверные настройки серверов инференса. В пользовательских материалах упомянута CVE-2026-7482 «Bleeding Llama» с CVSS 9.1 для Ollama до версии 0.17.1: по описанию, она позволяла получать переменные окружения, API-ключи, системные промпты и диалоги других пользователей. Идентификатор, версию и масштаб перед публикацией нужно сверять по официальным базам, но сам класс риска реален: локальная модель, открытая в сеть без защиты, превращается в новую точку утечки.
REST API Ollama и аналогичные инструменты часто поднимают «на попробовать». Если такой сервер остаётся доступным без аутентификации, любой пользователь сети получает доступ не только к вычислениям, но и к тому, что проходит через модель. К этому добавляются риски из OWASP Top 10 для приложений с языковыми моделями: prompt injection, утечки через ответы, небезопасные плагины, чрезмерные права агента. Локальное размещение не защищает от атаки, которая приходит через содержимое документа.
Минимальный контур безопасности включает аутентификацию на всех точках доступа, сетевую изоляцию, журналирование, ротацию ключей, отдельные учётные записи для сервисов, регулярные обновления, контроль исходящих соединений и резервное копирование. Отдельно проектируют разграничение доступа к базе знаний. Модель не знает, что сотруднику нельзя видеть договор другого подразделения, если это не проверено в коде и в поисковом слое.
Гибрид: чаще всего правильный ответ
Во многих компаниях правильный ответ — не «всё в облаке» и не «всё своё», а разделение потока по чувствительности данных. Чувствительные запросы идут на локальную модель, остальные — на облачную. Такой подход позволяет не переплачивать за полный закрытый контур там, где он не нужен, и одновременно не отправлять наружу то, что должно оставаться внутри.
Гибридная архитектура обычно включает маршрутизацию запросов, обезличивание, разные классы моделей и контроль отказов. Например, агент может локально искать по договорам и кадровым документам, а облачную модель использовать только для стилистической редакции обезличенного текста. Если механизм обезличивания не сработал, запрос не должен уходить наружу. Это принцип «отказ в закрытое состояние»: при ошибке система становится строже, а не свободнее.
Есть неочевидные места, где безопасность ломается. В популярном шлюзе LiteLLM механизм резервного переключения моделей может по умолчанию обходить ограничения доступа, заданные для ключа. То есть запрос, которому запрещено уходить на внешнюю модель, при сбое локальной модели рискует уйти наружу. Для такого сценария требуется явная настройка enforce_fallback_model_access: true и проверка поведения на тестах отказа.
Гибрид особенно полезен, когда у компании есть разные классы данных. Бухгалтерские документы и персональные данные остаются в периметре, общие вопросы по открытым инструкциям могут идти в российское облако, а задачи без чувствительной информации — в более сильную внешнюю модель. Такая архитектура требует аккуратного технического задания: какие данные, какой регулятор, какие роли пользователей, какие журналы, какие запреты на передачу наружу.
Что делать дальше
Перед выбором локального ИИ-агента стоит провести оценку выполнимости в закрытом контуре. Для этого фиксируют три группы требований: какие данные обрабатываются, какой регулятор или внутренняя политика применимы, есть ли аттестация или требования КИИ, а также какой ожидается объём обращений — в токенах, документах, пользователях и пиковых часах.
Результатом такой оценки должны быть три сравнимых варианта размещения: публичное облако, российское облако с хранением и обработкой в РФ, собственный контур. Для каждого варианта указывают стоимость владения за три года, ограничения по качеству, требования к железу, риски поставки, требования к сопровождению и то, какие пункты безопасности закрываются, а какие остаются на стороне заказчика.
Важно говорить прямо: внедрение ИИ-агента и его размещение в закрытом контуре не равны аттестации информационной системы. Аттестация, сертификация и лицензируемые работы по требованиям ФСТЭК выполняются профильными подрядчиками с соответствующими компетенциями и разрешениями. Наша зона ответственности в таком проекте — архитектура агента, выбор модели, интеграция с данными, настройка разграничения доступа и подготовка технической части, которую затем можно согласовывать с командой информационной безопасности и профильным подрядчиком заказчика.
Закрытый контур имеет смысл там, где данные и регулятор действительно требуют контроля. Во всех остальных случаях он должен конкурировать с облаком не лозунгом «безопаснее», а цифрами: стоимостью, качеством, сроком запуска и проверенной моделью угроз.
 Автор
Антон Амосов


